Para instalar o Elasticsearch no Ubuntu, a melhor forma é utilizando o repositório oficial. Como pré-requisito, é necessário instalar o Java 8 ou superior (instale o de sua preferência) e o repositório apt via https:
sudo apt install apt-transport-https openjdk-8-jdkImporte a chave do repositorio:
wget -qO - https://artifacts.elastic.co/GPG-KEY-elasticsearch | sudo apt-key add -O resultado deverá ser OK. Adicione o repositório do Elasticsearch da versão 7. Se quiser você pode alterar para uma versão anterior:
sudo sh -c 'echo "deb https://artifacts.elastic.co/packages/7.x/apt stable main" > /etc/apt/sources.list.d/elastic-7.x.list'Atualize o apt e instale normalmente o pacote elasticsearch:
sudo apt update && apt install elasticsearchVocê pode habilitar como serviço:
sudo systemctl enable elasticsearch.serviceOu iniciar de acordo com a demanda:
sudo systemctl start elasticsearch.serviceVeja se está funcionando:
curl localhost:9200Pronto!
]]>Para habilitar, acesse o WebLogic console. Vá em Environment, Server e escolha o server no qual você deseja habilitar o System.out e System.err no log. Acesse a aba Logging, General e Advanced.
Selecione os dois combos onde diz para redirecionar o stdout e stderr para o log.
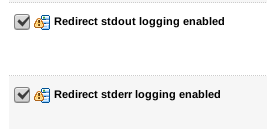
Pronto! Só não faça isso em ambiente de produção.
]]>- Ponto e vírgula é opcional
- Constantes não precisam de tipo e são declaradas com a palavra val. Ex: val titulo = “Blog” é o equivalente em Java a final String titulo = “Blog”;
- Variáveis também não precisam de tipo e são declaradas com a palavra var. Ex: var nome = “Vespa” é o equivalente em Java a String nome = “Vespa”;
- Quando necessário identificar o tipo da variável, constante ou retorno de função é só colocar dois pontos e o tipo após a declaração. Ex: var nome: String
- Quando a variável permite nulo é só colocar o ponto de interrogação no tipo. Ex: var nome: String? = null
- O operador ternário para verificação de nulo para atribuição de valor default não é mais necessário (e não existe). Isso também é feito com o ponto de interrogação. Ex: var tamanho = nome?.length ?: 0 (Se o nome for nulo o valor para tamanho é zero, caso contrário é o tamanho). Você também pode executar uma ação como dar um return na função ou lançar uma exceção.
- Declaração de funções (de modo grosseiro: o equivalente a métodos em java). Utilize fun.
[sourcecode] fun soma(a: Int, b: Int): Int { return a + b } [/sourcecode] ou [sourcecode] fun soma(a: Int, b: Int) = a + b [/sourcecode]
- O construtor primário é definido já na declaração de classe. Ex: class Pessoa(val nome: String, var idade: Int)
- Herança é feita semelhante à declaração de tipos de variáveis, mas passando o construtor que será chamado. Ex: class PessoaJuridica(nome: String) : Pessoa (nome)
- Para sobrescrever uma função, é necessário usar a palavra override.
Há outros recursos bem interessantes do Kotlin, como Data classes, expressão When, coleções, extensões e afins, que abordaremos em outros artigos. Aguarde!
]]>[code language=”bash”]> stat 412412312.txt
File: 412412312.txt
Size: 0 Blocks: 0 IO Block: 4096 regular empty file
Device: 802h/2050d Inode: 17563908 Links: 1
Access: (0644/-rw-r–r–) Uid: ( 1000/ thiago) Gid: ( 1000/ thiago)
Access: 2018-09-14 14:57:44.899000835 -0300
Modify: 2018-09-14 14:57:44.899000835 -0300
Change: 2018-09-14 14:58:39.583004882 -0300
Birth: -[/code]
Com isso sabemos que esses atributos estão disponíveis no arquivo. Para recuperar todos esses atributos do contexto Unix, no Java, pode-se utilizar o seguinte comando:
[code language=”java”] Path path = Paths.get(filePath);
Map f = Files.readAttributes(path, "unix:*");
System.out.println(f);[/code]
Onde filePath é o caminho onde está o arquivo/diretório. Ou, se deseja recuperar apenas um atributo, como o Change Time (ctime), pode-se realizar da seguinte forma:
[code language=”java”] System.out.println(Files.getAttribute(path,"unix:ctime"));
[/code]
Para mais informações de como trabalhar com atributos, pode-se encontrar aqui.
]]>Uma das maneiras mais simples é você transformar numa string, invertê-la e converter novamente em um número, entretanto há uma outra forma sem ser necessária a conversão para string. Você pode ir dividindo por 10 no número original (recuperando a unidade, dezena, centena, …) e multiplicando por 10 no invertido (inserindo os valores como centena, dezena, unidade).
[source language=”java”]
int rev = 0;
while(n>0) {
int lDigit = n%10;
rev = (rev*10)+lDigit;
n/=10;
}
System.out.println(rev);
[/source]
No nosso exemplo: 3210. A linha 3, irá recuperar o resto da divisão de 3210 por 10, que é 0. Esse resultado é atribuído ao nosso número invertido, já que na primeira iteração o valor de rev é 0. Removemos a parte da unidade do nosso número, dividindo ele por 10 (n = 3210/10 = 321).
Na segunda iteração, na linha 3, o resto da divisão de 321 por 10 é 1. Esse resultado é atribuído ao nosso número invertido, já que ele ainda está com o valor 0, portanto rev = 1. Removemos a parte das dezenas do nosso número, dividindo ele novamente por 10 (n=321/10 = 32).
Na terceira iteração, na linha 3, o resto da divisão de 32 por 10 é 2. O valor de rev é multiplicado por 10 (1*10 = 10) e atribuído o valor do resto da divisão (rev = 10+2 = 12). Removemos a parte das centenas do nosso número, dividindo ele novamente por 10 (n=32/10 = 3).
Na quarta iteração finalizamos e n a linha 3 o resto da divisão de 3 por 10 é 3. O valor de rev é multiplicado por 10 (12*10 = 120) e atribuído o valor do resto da divisão (rev = 120+3). Removemos a parte do milhar do nosso número, dividindo ele novamente por 10 (n=3/10 = 0).
Com isso temos o número invertido (rev) com o valor 123 e o n com o valor 0, saindo do loop e com o nosso número invertido, como queríamos.
]]>Ao estudar um pouco sobre as fases lunares, me deparei com um algoritmo muito interessante do matemático John Horton Conway. Ele cria um método para facilitar sabermos as fases lunares, sem a necessidade de cálculos elaborados, apenas com contas que conseguimos realizar mentalmente. Por isso, resolvi incrementar um pouco o algoritmo de fases lunares que eu havia feito e também implementar esse algoritmo mental. Se você ainda não viu a versão simplificada, para computadores, considerando somente o período sinódico, dê uma olhada aqui.
O algoritmo de Conway consiste em achar um padrão apenas utilizando contas simples para as fases lunares do século XX e XXI. Embora ele não tenha calculado os valores para os outros anos, creio que seja possível fazer apenas alterando um parâmetro na somatória final (tentarei posteriormente). A ideia desse algoritmo é que ele possa ser armazenado mentalmente para você saber as fases da lua, sem olhar para o céu.
Em resumo você considera apenas os dois últimos dígitos do ano, calcula o resto da divisão dele por 19 e se for maior que 9, subtraia 19. Multiplica o resultado por 11, calcula o resto da divisão por 30. Subtrai 4, para o século XX ou subtrai 8 para o século XXI e acha o resto da divisão por 30 novamente. Soma com o dia e o mês (se for janeiro ou fevereiro você soma 2). Se você achar difícil, olhe para o céu :D. Para o ano atual (2018), podemos já adiantar uma parte do algoritmo para facilitar o cálculo mental:
- resto da divisão de 18 (dois últimos dígitos) por 19 é 18
- como é maior que 9, subtraia 19; temos: 18-19 = -1
- multiplica o resultado por 11; temos: -1 * 11 = -11
- resto da divisão de -11 por 30 é 19
- como estamos no século XXI, subtrai 8; temos 19 – 8 = 11
- resto da divisão de 11 por 30 é 11
Essa a parte do cálculo que utiliza o ano. Então para o ano de 2018, você não precisa mais realizar nenhum cálculo, o valor obtido é 11 (pode decorar esse número, que até o fim desse ano ele é válido). Caso ache interessante, calcule para os outros anos. Para o dia e mês de hoje (05 de abril) é só fazer a seguinte conta:
- número obtido (no caso é 11) + dia + mês; temos: 11+5+4 = 20
- Se for janeiro ou fevereiro soma-se mais 2… não é o caso nosso
Com isso você só precisa saber o número 11 e somar com outros 2 números para saber o dia lunar que estamos. Que no caso é dia 20. Fácil, né? Para saber a fase da lua, você pode utilizar a seguinte tabela:
- Lua Nova – 0, 1, 29
- Crescente – de 2 a 6
- Quarto crescente – 7 e 8
- Crescente gibosa – de 9 a 13
- Cheia – de 14 a 16
- Minguante gibosa – de 17 a 21
- Quarto minguante – 22 e 23
- Minguante – de 24 a 28
Ou se preferir é só lembrar que quanto mais próximo do valor 15 estiver, mais cheia está a lua e assim não precisa decorar mais nada.
Com isso, resolvi implementar essa lógica do algoritmo, incrementando alguns valores. Ela pode ser encontrada aqui e aqui. O código está baseado na versão anterior (veja antes de utilizar o novo). Para a tabela de luas, criei uma função com condicionais (preciso melhorar):
[code language=”java”] public static MoonPhase getMoonPhaseConway(int lunarDay) {
if(lunarDay<=28) { if(lunarDay>=24) {
return MoonPhase.WANING_CRESCENT;
}
if(lunarDay>=22) {
return MoonPhase.THIRD_QUARTER;
}
if(lunarDay>=17) {
return MoonPhase.WANING_GIBBOUS;
}
if(lunarDay>=14) {
return MoonPhase.FULL_MOON;
}
if(lunarDay>=9) {
return MoonPhase.WAXING_GIBBOUS;
}
if(lunarDay>=7) {
return MoonPhase.FIRST_QUARTER;
}
if(lunarDay>=2) {
return MoonPhase.WAXING_CRESCENT;
}
}
return MoonPhase.NEW_MOON; //0,1,29
}[/code]
E o código da lógica:
[code language=”java” highlight=”18″] public static int getLunarDayConway(LocalDateTime ldt) {
var year = ldt.getYear();
var month = ldt.getMonthValue();
var day = ldt.getDayOfMonth();
if(year < 1900 || year >= 2100) throw new RuntimeException("Date must be greater than 1900 and less than 2100");
var centS = -4.0;
if(year > 2000) {
centS = -8.3;
}
var lastTwoDigits = year%100.0;
double vl = lastTwoDigits % 19;
if(vl > 9) {
vl-=19.0;
}
vl*=11.0;
vl%=30;
vl+=centS;
vl+=month+day;
if(month<3) {
vl+=2;
}
vl = Math.round(vl)%30;
return (int)((vl < 0) ? vl+30 : vl);
}[/code]
Da linha 7 a 17 é o cálculo do valor referente ao ano, que no nosso caso (2018) é 11. E na linha 18 é a soma que fazemos do mês e do dia para descobrir o dia lunar.
]]>A lua passa por todas as suas fases em um período com mais ou menos 29,5 dias, também chamado de lunação. Esse período é conhecido como mês sinódico. É diferente do período que ela circunda a terra (27,3 dias), que é conhecido como mês sideral. Essa diferença é referente ao movimento orbital da Terra em torno do sol.
Para calcular as fases da lua, a ideia é bem simples. É preciso conhecer uma data com lua nova. No exemplo utilizei dia 07 de janeiro de 1970. Como o ciclo é de 29,5 dias, é necessário calcular a diferença entre essas datas e o resto da divisão pelo período sinódico e temos o número de dias lunares que passou à partir de uma lua nova. Pois a cada 29,5 dias temos uma outra lua nova. Ou seja:
DiaLunar = (DiaVerificar – DataDaLuaNova) mod PeriodoSinótico
Para saber o tipo de luas, é só verificar a quantidade de dias do período sinótico (29,5 dias) e dividir pela quantidade de luas (8 no caso), que dá aproximadamente 3,7. Então a cada 3,7 dias temos um novo tipo de lua.
Criei um enum para as fases da lua para ficar melhor organizado o código:
[code language=”java”] static enum MoonPhase {
NEW_MOON, // Nova
WAXING_CRESCENT, // Crescente
FIRST_QUARTER, // Quarto crescente
WAXING_GIBBOUS, // Crescente gibosa
FULL_MOON, // Cheia
WANING_GIBBOUS, // Minguante gibosa
THIRD_QUARTER, // Quarto minguante
WANING_CRESCENT; // Minguante
}[/code]
Criei duas constantes para serem utilizadas posteriormente em outros códigos:
[code language=”java”] public static final long SYNODIC_PERIOD = 2551442877L; //29.530588854 days
public static final LocalDateTime KNOWN_NEW_MOON = LocalDate.of(1970, Month.JANUARY, 7).atStartOfDay();[/code]
A lua nova é início do mês para os judeus e é chamada de ראש חודש ou Rosh Chodesh, traduzido como cabeça do mês. Nesse dia se comemora a Festa da Lua Nova, 14 dias após esse dia é lua cheia, e no primeiro mês judaico (Nisan ou Abibe) é onde inicia o Pessach. Para se recuperar o dia lunar, que começa a contar à partir da primeira lua nova do mês, é necessário calcular a diferença entre uma lua nova conhecida e a data a ser verificada e ver o resto da divisão pelo período sinódico:
[code language=”java”] public static int getLunarDay(LocalDateTime day) {
var lunarDay = (int) Duration.ofMillis(Duration.between(KNOWN_NEW_MOON, day).toMillis() % SYNODIC_PERIOD).toDays();
return lunarDay;
}[/code]
Com isso, para saber a fase atual da lua é só dividir pela diferença de cada lua, que, como dito anteriormente, é de aproximadamente 3,7 dias:
[code language=”java”] public static MoonPhase getMoonPhase(int lunarDay) {
var phaseNum = (int)Math.floor(lunarDay/3.7);
return MoonPhase.values()[phaseNum];
}[/code]
E para usar os dados utilizei o método main para imprimir a data, o dia lunar e a fase da lua de agora até 1 mês para frente:
[code language=”java” highlight=”4,5,6″] public static void main(String[] args) {
var now = LocalDateTime.now();
var end = now.plusMonths(1);
Stream.iterate(now, date -> date.plusDays(1))
.limit(ChronoUnit.DAYS.between(now, end))
.forEach(MoonUtils::printLunarAnalysis);
}
private static void printLunarAnalysis(LocalDateTime ldt) {
var df = DateTimeFormatter
.ofLocalizedDate(FormatStyle.SHORT)
.withLocale(new Locale("pt", "br"));
var lunarDay = getLunarDay(ldt);
var moonPhase = getMoonPhase(lunarDay);
System.out.println("Data: " + ldt.format(df));
System.out.println("Dia lunar: " + lunarDay);
System.out.println("Fase da lua (provável): " + moonPhase);
System.out.println();
}[/code]
Nas linhas 4 a 6 estou utilizando expressões lambda junto com a interação do Java 8 e method reference. A inferência da declaração var do Java 10, que está em todo código, também funciona adequadamente. Com isso, aprendemos utilizar alguns dos novos recursos do Java e, caso você necessite em alguma aplicação ou calendário, conseguimos descobrir qual fase da lua estamos.
]]>- Manualmente: criar outro array e copiar elemento a elemento
- Utilizar System.arraycopy
- Utilizar Arrays.copyOfRange ou Arrays.copyOf para versão do Java maior ou igual a 1.6
Qual deles é melhor? Criei um código simples de teste que copia 1 milhão de arrays de int com tamanho de 2048. Para a cópia manual foi utilizado o seguinte código:
[sourcecode language=”java”] for(int idx=0;idx<copied.length;idx++) {
copied[idx] = toCopy[idx];
}[/sourcecode]
Para o System.arraycopy:
[sourcecode language=”java”]System.arraycopy(toCopy,0,copied,0,copied.length);[/sourcecode]
E para o Arrays.copyOf:
[sourcecode language=”java”]copied = Arrays.copyOf(toCopy, copied.length);[/sourcecode]
Claro que isso não é um bechmarking muito confiável, mas é só para ter uma noção, logo mais analisaremos a implementação deles. Ao executar os testes na minha máquina a média de execução para as cópias de 1 milhão de arrays na implementação manual foi de 293 millisegundos, para o da classe System, 195 millisegundos e para o da classe Arrays, 1126 millisegundos. Lembrando que não estamos considerando as instanciações dos arrays. Se fizermos isso, o tempo vai ser semelhante para os 3 métodos, já que o tempo de alocação de memória é enormemente maior que o de cópia do array e por esse motivo o Arrays.copyOf demora mais, já que ele faz a instanciação interna conforme veremos posteriormente.
O System.arraycopy utiliza implementação nativa:
[sourcecode language=”java”]public static native void arraycopy(Object src, int srcPos,
Object dest, int destPos,
int length);[/sourcecode]
O código em C++ pode ser visto na source do jdk, por ser nativo e ter diretivas de desempenho específicas para esse método, o método utilizando System.arraycopy tende a ser mais eficiente que o método manual.
Para o Arrays.copyOf temos a seguinte implementação:
[sourcecode language=”java” highlight=”2″] public static int[] copyOf(int[] original, int newLength) {
int[] copy = new int[newLength];
System.arraycopy(original, 0, copy, 0,
Math.min(original.length, newLength));
return copy;
}[/sourcecode]
Como podemos ver na linha 2, ele instancia o array, por isso acaba sendo mais lento que os outros no quesito tempo de execução individual do métodos, mas ele utiliza o System.arraycopy para realizar a cópia.
Meu veridito para uso dos métodos de cópias de array é: nunca utilize o método manual se for cópia simples, utilize o System.arraycopy quando você já tiver o objeto de destino da cópia instanciado ou sua versão do Java é inferior a 1.6 e o Arrays.copyOf em todos os outros casos, pois facilita a leitura e é tão performático quanto o System.arraycopy se você considerar o tempo de instanciação (que é feito internamente).
[sourcecode language=”java”] long startTime = System.currentTimeMillis();
metodoDemorado();
long totalTime = System.currentTimeMillis() – startTime;[/sourcecode]
Pode-se substituir o currentTimeMillis() por nanoTime(). A diferença dos dois está que o currentTimeMillis utiliza o relógio da máquina para pegar a quantidade de millisegundos desde às 00hs do dia 01 de Janeiro de 1970 UTC até o momento atual. Já o nanoTime() não é baseado em relógio e usa o timer mais preciso que exista na máquina e por isso só pode ser utilizado para medida de tempo de execução e não relacionado com o relógio da máquina.
[sourcecode language=”java”] long startTime = System.nanoTime();
metodoDemorado();
long totalTime = System.nanoTime() – startTime;[/sourcecode]
Maiores informações nesse link.
Agora o mais legal que eu estou utilizando atualmente é a nova API (java.time) do Java 8, principalmente as classes Instant e Duration. O código é mais legível e tem mais funcionalidade para trabalhar com a duração (Duration) que é retornada entre um momento ou instante (Instant) e outro. Uma observação, o tempo não é tão preciso, normalmente é interessante quando precisão de segundos é suficiente.
[sourcecode language=”java”] Instant startTime = Instant.now();
metodoDemorado();
Instant endTime = Instant.now();
Duration totalTime = Duration.between(startTime, endTime);
[/sourcecode]
Agora, para quem vai trabalhar com bechmarking de várias threads e não o tempo que o sistema fica aguardando o método ser executado é interessante utilizar medidas como User Time e System Time. Para isso existe o ThreadMXBean que recupera dados direto da JVM, mas esse assunto é tópico para um outro post.
]]>A própria documentação da Oracle deixa claro que a função do gerenciamento de threads é do próprio container. A especificação diz que é proibido o uso de threads.
The enterprise bean must not attempt to manage threads. The enterprise bean must not attempt to start, stop, suspend, or resume a thread, or to change a thread’s priority or name. The enterprise bean must not attempt to manage thread groups.
Permitir que a aplicação faça o controle de threads irá interferir no controle do ciclo de vida dos componentes do container. Então estamos proibidos de usar threads diretamente na aplicação (elas existem, mas controladas pelo container). O uso direto delas implicaria na violação e perda dos recursos fornecidos pelo container: segurança, clustering, controle de transação e afins.
Mesmo o controle sendo feito no container, podemos utilizar as vantagens que as threads oferecem sem comprometer a integridade do container. Na maioria dos casos, conhecer os componentes possíveis da arquitetura é suficiente para não utilizar threads diretamente. Por exemplo, um envio de e-mail em lote pode ser desenvolvido com uma fila JMS em conjunto com um MDB. Um agendamento, pode ser feito utilizando Quartz ou um Timer Service.
Além das threads, se você leu as referências acima, irá ver que não podemos nem gravar arquivos dentro do container, pois você perderia o controle da concorrência, em ambientes clusterizados você teria problemas com arquivos que não são distribuídos em várias máquinas, operações com arquivos também não são transacionais e teria problemas com segurança. Caso deseja realmente fazer isso, você terá que desenvolver esse controle manualmente, como um sistema de arquivo distribuido entre os nós do cluster, controle de transação manual como um arquivo de lock, um controle de concorrência para garantir que um arquivo seja lido ou escrito por vez, eliminando a concorrência entre os clusters e um mecanismo de detecção ou compensação de erro ou rollback em caso de falhas entre as operações utilizando arquivos. O que não é uma tarefa fácil, mas às vezes se faz necessário.
Há casos específicos que existe a necessidade de uso threads, mas devemos fazer isso sem comprometer o container, para isso há soluções como a JSR 236, que é a api de utilitários de concorrência (vulgo, usar thread do jeito certo) e se tornou padrão na especificação do JEE 7. Há uma boa referência do uso aqui e aqui.
Resumindo: Evite o uso de threads em escopo JEE, caso você identifique a necessidade, verifique se algum componente padrão resolve o seu problema, caso contrário, utilze APIs adequadas para usar threads sem comprometer os recursos fornecidos pelo JEE.
]]>